qKnow 开源版 v2.4.3 发布:数据接入能力再拓展,知识构建自定义能力上新
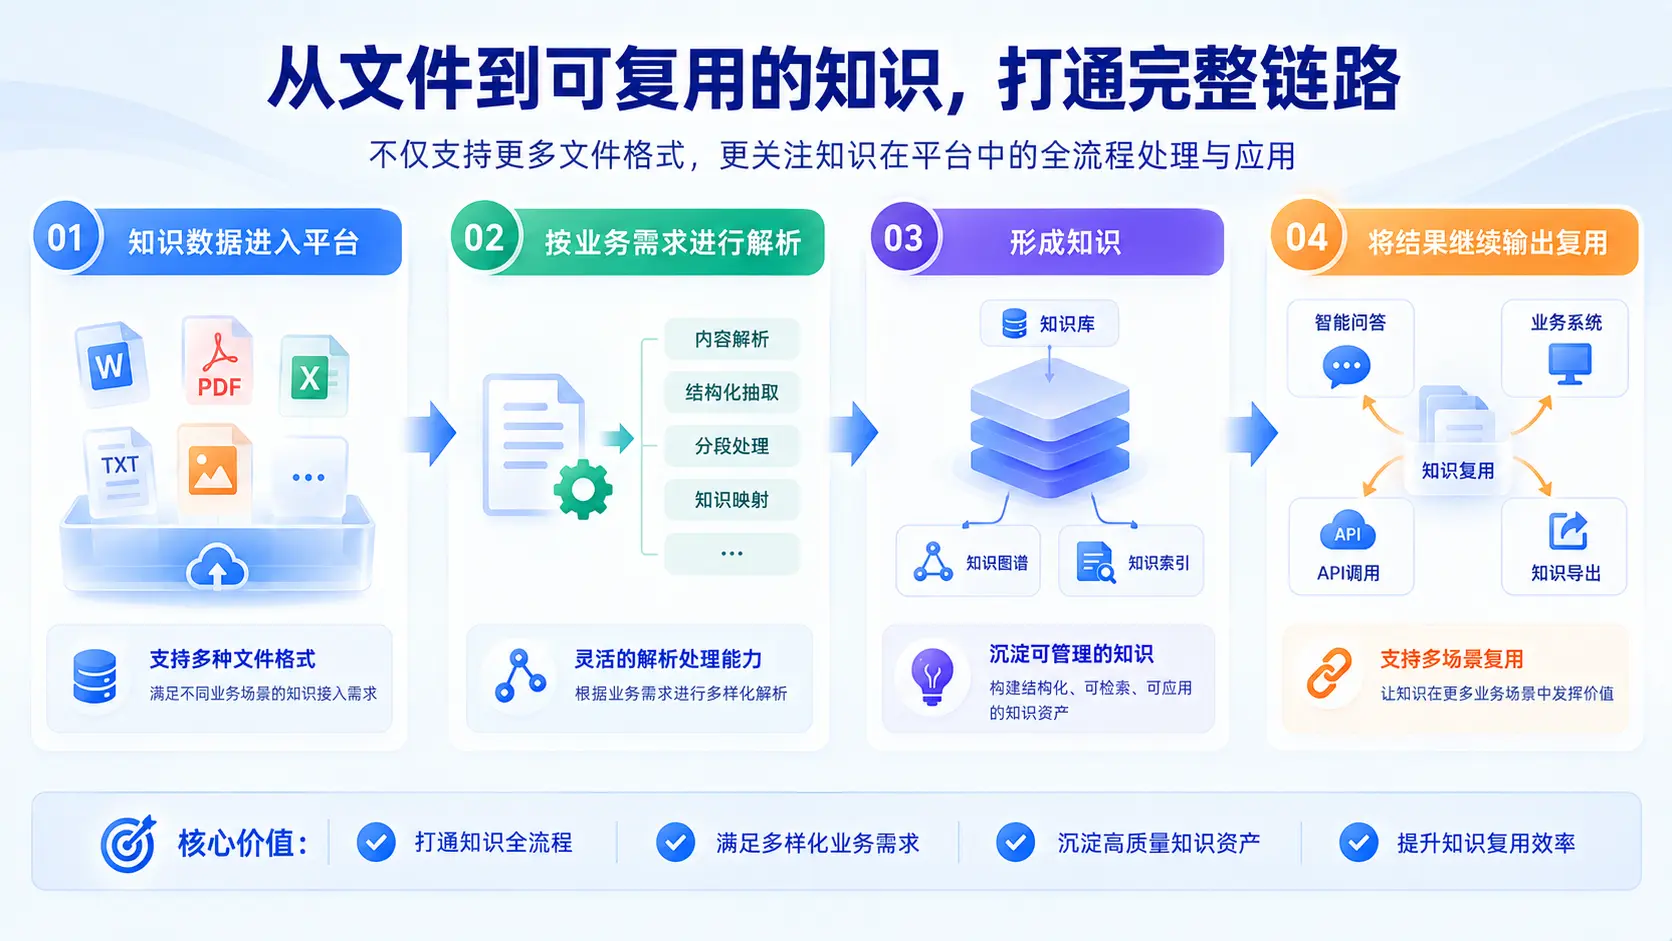
qKnow智能体构建平台开源版v2.4.3围绕非结构化知识接入、知识资产导出和文档解析自定义能力进行升级,主要包括:知识库、知识图谱新增JSON/JSONL文件导入能力,知识库问答数据支持JSON/JSONL一键导出,并开放文件解析模型与提示词自定义能力,进一步完善非结构化文档从接入、解析到复用的处理链路。 从“把文档传进来”,到让知识数据能够接入、加工和复用 企业建设知识库和智能体时,原始知识通常并不只有Word、PDF等常规文档。 在实际项目中,还会存在经过其他系统处理后的文档解析结果、半结构化数据,以及已经整理完成的问答数据集。 这意味着企业知识处理过程并不是简单的: 上传文件 → 完成解析 → 建成知识库 而更接近: 外部数据准备 → 数据导入 → 文档解析 → 知识生成 → 数据导出 → 二次加工与复用 当平台的数据进出方式和解析逻辑比较固定时,随着企业知识场景增加,会逐渐出现三个问题: 已经完成解析或整理的JSON/JSONL数据,缺少标准导入入口; 知识库生成的问答知识无法方便地导出,用于外部加工或数据集沉淀; 不同类型文档需要不同解析逻辑,但解析模型和提示词固定,用户难以根据业务场景调整。 因此,qKnow开源版v2.4.3此次调整的重点,不只是增加新的文件格式,而是进一步补齐: 知识数据进入平台 → 按业务需求进行解析 → 形成知识 → 将结果继续输出复用 这一完整链路。 知识库、知识图谱新增JSON/JSONL导入,扩展知识数据接入方式 过去,qKnow知识库和知识图谱主要按照已有文件上传方式接入知识。 但在企业实际数据处理中,一部分非结构化文档可能已经在其他系统中完成了解析、转换或整理,最终形成JSON、JSONL等结构化程度更高的数据。 如果平台只能重新从原始文件开始处理,就会面临: 已有解析结果无法直接利用,只能重新转换或重新上传。 qKnow开源版v2.4.3新增知识库、知识图谱的JSON/JSONL文件导入能力,进一步为这类数据提供标准接入入口。 支持直接上传JSON和JSONL文件 本次版本支持上传: JSON; JSONL。 两类文件格式。 这意味着已经完成整理的数据,不一定需要重新还原成原始文档再进入平台,而可以根据实际数据形态直接进行导入。 从知识接入过程来看,可以进一步形成: 原始文档 → 外部解析 / 数据加工 → JSON / JSONL → qKnow知识库 / 知识图谱 这种方式更适合企业已经存在文档处理流程,或者需要把其他系统生成的数据继续接入qKnow的场景。 区分非结构化与半结构化数据源 本次更新不仅增加文件后缀支持,还进一步区分了: 非结构化数据; 半结构化数据。 用于适配不同类型的数据接入场景。 JSON、JSONL虽然本身具有一定结构,但其承载内容可能来源于非结构化文档解析结果,也可能本身就是已经整理过的半结构化知识数据。 因此,数据接入不再只有“上传普通文档”这一种路径,而是进一步允许不同形态的知识数据进入后续处理流程。 补齐文档解析结果重新接入平台的路径 这一能力比较重要的一个应用方向,是: 已经完成文档解析的数据再次进入平台。 例如,企业可能通过其他解析工具先完成文件处理,再将结果按照JSON或JSONL格式沉淀。 过去这类数据缺少标准化接入方式。 qData 开源版v2.4.3补充导入入口后,可以减少: 解析完成 → 再转成普通文件 → 再重新解析 这类重复处理。 需要说明的是,JSON/JSONL导入能力解决的是数据接入问题。 数据导入之后具体如何进入知识解析、知识构建和后续应用,仍需要结合实际数据格式以及企业自身的知识建设流程进行配置。 知识库问答数据支持JSON/JSONL导出,让知识结果能够继续复用 知识平台除了要解决“数据怎么进来”,还需要考虑另一个问题: 平台产生的知识数据能不能继续出去? 在企业知识库建设过程中,一份文档经过解析以后,可能形成大量问答知识。 这些数据不仅可以用于当前知识库,也可能继续用于: 外部系统处理; 数据集整理; 模型评测; 数据标注; 后续知识加工; 跨系统复用。 如果解析结果只能留在平台内部,知识资产就很难继续流转。 原有版本中,知识库问答数据缺少标准化导出能力,用户生成的非结构化文档知识难以用于外部二次处理和数据集沉淀。 问答数据可以一键导出为JSON/JSONL qKnow开源版v2.4.3新增知识库问答数据导出能力。 完成非结构化文档解析并建立知识库后,可以根据需要将问答数据导出为: JSON; JSONL。 标准格式文件。 整个流程可以理解为: 上传文档 → 文档解析 → 生成问答知识 → 建立知识库 → 导出JSON / JSONL → 外部继续处理 这样,平台生成的知识数据不再只能停留在当前知识库中。 为数据集沉淀提供标准输出方式 对于长期建设企业智能体的团队来说,知识库中的问答数据本身也是一种可持续沉淀的数据资产。 例如,同一批问答数据可能用于: 知识问答效果验证; 测试集建设; 训练数据准备; 外部知识系统使用; 后续人工审核与整理。 通过JSON/JSONL导出,可以让这些数据更方便地进入其他处理流程。 相比人工复制或者重新整理,标准格式更适合后续批量处理。 从“知识库结果”,进一步变成“可流转知识资产” 从知识治理角度看,这项能力带来的变化在于: 过去更加偏向: 文件进入平台 → 解析 → 在平台内部使用 现在则进一步形成: 文件进入平台 → 解析 → 形成知识 → 平台内部使用 → 标准格式导出 → 外部再次加工与复用 这样可以提高文档类知识资产在不同工具和业务流程之间的流转灵活性。 不过,导出问答数据并不意味着这些内容天然适合所有其他业务场景。 如果用于模型训练、效果评估或其他系统,还需要根据具体用途继续进行质量审核、格式检查和数据处理。 开放文件解析模型与提示词自定义,让解析逻辑适配不同业务文档 企业文档之间的差异往往非常大。 即使都是非结构化文档,也可能分别属于: 制度文件; 产品说明; 技术手册; 合同资料; 运维文档; 项目报告。 不同文件需要提取的信息并不完全相同。 例如,技术文档可能更加关注: 设备、参数、步骤、异常及处理方法 而制度文件可能更加关注: 适用范围、规则、职责和执行要求 如果所有文档都使用同一套固定解析逻辑,往往难以同时适配这些差异化场景。 原有版本中文件解析模型与提示词采用系统内置固定逻辑,用户无法自行调整。 开放解析模型选择能力 qKnow开源版v2.4.3进一步开放文件解析模型自定义能力。 用户可以结合自身业务需要,调整实际用于文档解析的模型。 这意味着文档解析不再完全依赖平台预设模型,而可以根据企业自身模型资源和解析需求进行调整。 从实际使用逻辑来看,可以理解为: 确定文档类型 → 选择适合的解析模型 → 配置提示词 → 执行解析 → 查看生成结果 提示词从系统固定,转向按业务场景配置 除了模型,本次版本也同步开放了解析提示词的自定义能力。 提示词直接影响模型: 需要提取哪些内容; 如何理解文档; 如何组织生成结果; 更关注哪些业务信息。 因此,同一个模型面对不同业务资料,也可以通过提示词调整解析目标。 例如,在不同场景中,用户可以让解析逻辑更加关注: 文档主要内容是什么 或者更加关注: 从文档中提取哪些特定业务知识。 这为企业根据自身知识治理规则调整解析生成逻辑提供了更多空间。 从统一解析逻辑,转向按文档场景配置 此次升级后,文件解析可以从过去相对固定的: 上传文档 → 使用系统固定模型与提示词 → 输出解析结果 调整为: 上传文档 → 根据业务选择解析模型 → 配置对应提示词 → 执行文档解析 → 查看并使用结果 这类能力尤其适合知识来源多、文档类型差异明显的企业。 它并不能保证通过更换模型或提示词就一定得到理想结果。 实际解析效果仍然与: 文档本身质量; 模型能力; 提示词设计; 文件内容复杂度; 实际业务目标 等因素相关。 因此,自定义能力解决的是解析逻辑可调整的问题,而不是自动替代企业对解析结果的验证与优化。 从“标准文件上传”,进一步形成更开放的知识处理链路 将本次三个功能结合起来,可以看到qKnow v2.4.3正在补充一条更加完整的知识数据链路。 过去更接近: 普通文件上传 → 系统固定解析 → 形成知识库 → 在平台内部使用 此次升级后,可以进一步形成: 原始文件 / JSON / JSONL → 数据导入 → 自定义模型与提示词解析 → 形成知识库问答数据 → JSON / JSONL导出 → 外部二次处理与复用 其中: JSON/JSONL导入解决的是:不同形态知识数据如何进入平台。 解析模型与提示词自定义解决的是:知识进入平台之后按照什么逻辑进行加工。 JSON/JSONL导出解决的是:知识处理完成以后如何继续流转和复用。 三项能力虽然分别属于数据接入、知识解析和数据输出,但共同指向的是: 让知识数据不只能够进入qKnow,也能够按照业务规则加工,并继续流向后续应用。 版本价值:让非结构化知识从接入到复用更加灵活 qKnow开源版v2.4.3此次升级主要围绕非结构化知识处理链路中的三个关键环节展开。 数据接入方式更加开放 知识库和知识图谱新增JSON/JSONL导入,让已解析、已整理的数据可以直接进入平台,减少部分重复转换和处理。 知识资产能够继续流转 知识库问答数据支持JSON/JSONL导出,使解析结果可以用于外部二次处理、数据集沉淀和后续复用。 文档解析逻辑更加可控 开放解析模型与提示词自定义后,用户可以根据业务文档类型和实际需求调整生成逻辑,提高不同知识场景下的配置灵活性。 整体来看,qKnow 开源版v2.4.3的版本价值并不是单纯增加几种文件格式,而是进一步打通知识数据的“导入—解析—导出”链路,让企业在非结构化知识构建过程中拥有更多自主配置和数据复用空间。 写在最后 qKnow开源版v2.4.3此次升级主要围绕三个方向展开: 知识接入:知识库、知识图谱支持JSON/JSONL文件导入; 知识复用:知识库问答数据支持JSON/JSONL一键导出; 知识解析:开放文件解析模型与提示词自定义能力。 这些能力让企业知识处理从单一文件上传,进一步延伸到标准数据接入、自定义解析和知识数据复用。 对于企业智能体建设来说,知识平台不仅需要“把知识建起来”,也需要让知识能够方便进入、按业务要求处理,并在需要时继续流转到其他应用中。 qKnow开源版v2.4.3此次更新,正是在进一步完善这条从知识接入到知识资产复用的完整链路。