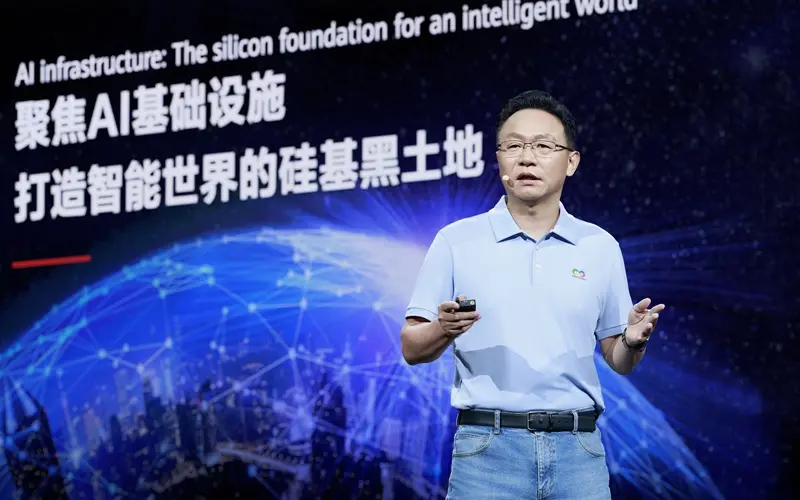
华为全联接大会 2026(Huawei Connect)今日在上海启幕,副董事长、轮值董事长汪涛做了开场主题演讲,抛出的核心命题很直白——智能世界需要更硬的算力底座,华为要做那块"硅基黑土地"。 汪涛给了一组压迫感很强的数字做铺垫:大模型参数正快速迈向 10 万亿,到 2030 年要过 100 万亿;智能体已经能按小时级连续工作,2030 年将以月为单位执行任务;中国每日推理 Token 已到 500 万亿左右,2030 年将是百万万亿级。算力、性能、可靠性,全都在被这些曲线往上顶。 AI 基础设施的核心突破,这次落在"超节点"上。华为发布了业界首个采用 NPO(近封装光学)技术的昇腾 960 超节点:单超节点 4096 卡,可提供 8E FP8 算力、1PB HBM 容量。它用 5500 个华为自研的 Hi-ONE 光互联产品,替代了原本需要的 4 万 8 千颗 800G 光模块,功耗降了 550 多千瓦,系统无故障运行时间翻倍,可用度到 99.8%。关键数字是有料的:4K 超节点组成的 10 万卡集群,相比 8 卡服务器组出来的同规模集群,MFU(模型浮点算力利用率)提升了 2.75 倍。 跟超节点配套,华为还升级了鲲鹏超节点和 AI 记忆存储。鲲鹏超节点最大支持 4096 节点、256TB 统一内存池;Agent 沙箱场景下十万级沙箱启动比传统服务器方案快 30 倍。存储侧基于灵衢 UnifiedBus 推出 OceanStor M900,面向 Agent 与长序列的多层 KV Cache 架构,SSD 读写寿命提升 16 倍。把这些子系统用灵衢统一互联协议串起来,再叠二层 CLOS 四平面组网和多轨道拓扑,华为给出的上限是:最大 100 万卡的昇腾超节点集群。规模数字从"十万卡"直接跳到"百万卡"。 面向开发者,生态数据是这场演讲里最值得看的部分。鲲鹏全球开发者超过 416 万、生态伙伴超 7200 家、支持 560 多个全球开源项目,openEuler 装机量超 2000 万套,坐稳中国服务器操作系统第一份额。昇腾这边则被描述为"已跨越生态拐点":CANN 进入常态化开源运营,外部开发者占比首次超过内部,达 61%,社区月活开发者破 5200 名;基于昇腾原生训练的模型超 40 个、是国内唯一支持预训练的技术路线;昇腾已覆盖 PyTorch、Triton、vLLM、veRL 等 90 多个主流三方社区。 最实在的一条:在 Linux 基金会支持下,昇腾正式成为可在 PyTorch 官网直接安装的算力平台,而且是首个来自中国的算力平台。这意味着全球开发者装 PyTorch 时能选昇腾后端了——开源生态这张牌,华为打得很明确:让开发者在主流通用技术栈里,不用绕路就能用到昇腾算力。 AI 基础设施军备竞赛正在把赌注越堆越大,从单卡卷到超节点、再卷到百万卡集群。而华为这次的姿态是:硬件上赌 NPO 光互联,生态上赌开源和 PyTorch 兼容。
华为押注“硅基黑土地”:昇腾 960 超节点、百万卡集群,还有 PyTorch 官方支持
来源:开源中国
2026年09月17日 18:01
0 阅读
分享到: